対応のないt検定
Independent samples t-test with boxplot in R
このページの目次
2つの独立したグループの平均差を比較し、箱ひげ図で分布を可視化する基本テーマです。『別々の人からなる2群を比べる』という場面を想定し、Student の t 検定と Welch の t 検定の考え方も含めて、初学者に分かる形で整理します。
このページでは、介入群と対照群のように、異なる個体からなる2群の平均を比べるときに使う対応のない t 検定を扱います。Rでの実装だけでなく、そもそも何を検定しているのか、どの前提条件を確認するのか、図と文章でどう伝えるのかまでをひとつの流れで確認できます。
対応あり t 検定との違いも意識しながら、『群は独立しているか』『平均差を見るのに t 検定でよいか』『等分散を仮定するか、Welch を使うか』という判断の入口をつかめる構成にしています。
このページで学ぶこと
- 対応のない t 検定が『独立した2群の平均差の検定』であることを理解する
- 群変数と連続変数を持つ基本データ構造を読み取り、箱ひげ図で分布の違いを確認できるようになる
- t 値・自由度・p 値・95%信頼区間・効果量 d の読み方を理解する
- 学術レポートや授業レポートで使える日本語/英語の結果記述を、そのまま応用できるようになる
まず押さえる4つのポイント
1. 比べるのは「別々の2群」
対応のない t 検定は、介入群と対照群のように、異なる個体からなる2群を比べる検定です。同じ人を前後で2回測るなら、対応あり t 検定を使います。
2. 平均差とばらつき
この検定では、各群の平均値の差が、群内のばらつきに比べて十分大きいかを確認します。差が大きくても、ばらつきが非常に大きいと有意にならないことがあります。
3. まず箱ひげ図で分布を見る
箱ひげ図を使うと、中央値、四分位範囲、外れ値候補をまとめて確認できます。検定の前に図を見ると、平均差の向きや外れ値の有無がつかみやすくなります。
4. Student と Welch を区別する
2群の分散が大きく違わないなら Student の t 検定、等分散が怪しいなら Welch の t 検定が候補です。初学者向けには、まず Welch を安全側の標準として覚えておくのも実務的です。
分析の概要と前提条件
どんなときに使うか
対応のない t 検定(独立2標本 t 検定)は、2つの独立したグループの平均値に差があるかを調べるときの基本手法です。たとえば、介入群と対照群、男性と女性、クラス A とクラス B など、同じ個体を2回測っているわけではない場面で使います。
必要なデータ形式:1行が1観測の long / tidy 形式で、group のような群変数と、score のような連続変数を持たせる形が分かりやすいです。
- 介入群と対照群のテスト得点を比べたいとき
- 2つの授業法で平均点が違うかを確認したいとき
- 2種類の製品条件で評価点を比較したいとき
- 同じ人を前後で測っているなら、対応あり t 検定を使います
- 3群以上を一度に比べるなら、一元配置 ANOVA が候補です
- 強い歪みや外れ値があり、平均差で見るのが不安なら Mann-Whitney の U 検定も検討します
t 値は何を表しているか
平均差を、その差の標準誤差で割ったものが t 値です。平均差が大きいほど、または群内のばらつきが小さいほど、t 値は大きくなります。
- 各観測値どうしが独立していること
- 各群の分布が極端に歪みすぎていないこと
- 強い外れ値が平均差を不自然に押し上げていないこと
- Student 版では等分散を仮定し、Welch 版ではその仮定を緩めます
前提条件はどう確認するか
対応のない t 検定では、独立性、分布の形、分散の違い、外れ値を順番に確認すると理解しやすくなります。
1. 独立性は設計で確認する
同じ人が両群に入っていないか、同一対象を重複して数えていないかを最初に確認します。ここは統計ソフトでは自動でチェックできません。
2. まず図で分布を眺める
箱ひげ図やヒストグラムを見て、平均差の向き、分布の広がり、外れ値候補を把握します。検定より先に図を見る習慣をつけると、解釈の質が上がります。
3. 等分散性は補助的に確認する
群ごとの SD が大きく違うなら、var.equal = FALSE として Welch の t 検定を使う選択が自然です。初学者は Student と Welch を区別して報告できれば十分です。
4. 外れ値は箱ひげ図で見つけやすい
外れ値候補が1〜2点だけあると、平均や t 値が大きく動くことがあります。結果を書く前に、外れ値の有無と扱い方をメモしておくと安心です。
データの形をつかむ
ここでは、介入群と対照群のテスト得点を比較するサンプルデータを使います。1行が1人、group が群、score が得点です。
サンプルデータの先頭
| id | group | score |
|---|---|---|
| 1 | Intervention | 79.6 |
| 2 | Intervention | 73.6 |
| 3 | Intervention | 74.5 |
| 4 | Intervention | 57.2 |
| 5 | Intervention | 93.3 |
| 6 | Intervention | 87.7 |
| 7 | Intervention | 75.2 |
| 8 | Intervention | 84.6 |
要約統計
| 群 | n | 平均 | SD | 中央値 |
|---|---|---|---|---|
| 介入群 | 24 | 78.28 | 7.22 | 79.35 |
| 対照群 | 24 | 72.38 | 9.16 | 73.45 |
| 平均差 | — | 5.90 | — | — |
この段階では、介入群の平均が対照群より高そうだと分かります。ただし、見かけの差が偶然のばらつきで説明できる範囲かどうかは、t 検定で確認します。
Rコードを順番に実行する
CSVを使う場合は、作業フォルダ内のsample-dataに保存してください。RStudioでは作業フォルダを設定してから、source("sample-data/t-test-independent-boxplot.R", echo = TRUE)で実行できます。必要なパッケージの導入コマンドはダウンロードしたファイルの冒頭にあります。
掲載例はR 4.3.3で実行確認しています。検証環境のパッケージ一覧(CSV)では、全記事の検証に使った環境の版を確認できます。
set.seed(20261028)  # 再実行時の乱数を固定
library(tidyverse)

dat <- read.csv("sample-data/sample_independent_t_scores.csv")
# 差の方向を「介入群 − 対照群」に揃える
dat$group <- factor(dat$group, levels = c("Intervention", "Control"))

# 群ごとの要約統計
dat %>%
  group_by(group) %>%
  summarise(
    n = n(),
    mean = mean(score),
    sd = sd(score),
    median = median(score)
)# Student の t 検定(等分散を仮定)
tt_student <- t.test(score ~ group, data = dat, var.equal = TRUE)
tt_student
# Welch の t 検定(等分散を仮定しない)
tt_welch <- t.test(score ~ group, data = dat, var.equal = FALSE)
tt_welch
# 効果量の例(手計算)
group_summary <- dat %>%
group_by(group) %>%
summarise(
n = n(),
mean = mean(score),
sd = sd(score)
)
spooled <- sqrt(((group_summary$sd[1]^2 * (group_summary$n[1] - 1)) +
(group_summary$sd[2]^2 * (group_summary$n[2] - 1))) /
(sum(group_summary$n) - 2))
cohens_d <- (group_summary$mean[1] - group_summary$mean[2]) / spooled
cohens_dlibrary(ggplot2)
ggplot(dat, aes(x = group, y = score, fill = group)) +
geom_boxplot(width = 0.62, alpha = 0.7, outlier.shape = 21) +
stat_summary(fun = mean, geom = "point", size = 3, color = "black") +
labs(
x = NULL,
y = "Test score",
title = "Distribution of test scores by group"
) +
theme_minimal(base_size = 13) +
theme(legend.position = "none")出力のどこを読めばよいか
検定結果を読むときは、群平均、平均差、t 値と自由度、p 値、必要に応じて効果量の順に確認すると整理しやすくなります。
介入群
対照群
p = 0.017
中程度の差の目安
この出力をどう解釈するか
このサンプルでは、介入群の平均得点は対照群より約 5.90 点高く、Student の t 検定では t(46) = 2.48, p = 0.017 でした。したがって、5%水準では「2群の平均が等しい」という帰無仮説を棄却し、介入群の方が高い得点を示したと解釈できます。
ただし、p 値だけで終わらず、差の大きさも確認すると実務で使いやすくなります。ここでは Cohen の d が 0.72 なので、介入群と対照群の差は「小さすぎる差」ではなく、図でも確認できる程度の広がりを持っていると説明できます。
箱ひげ図をどう読むか
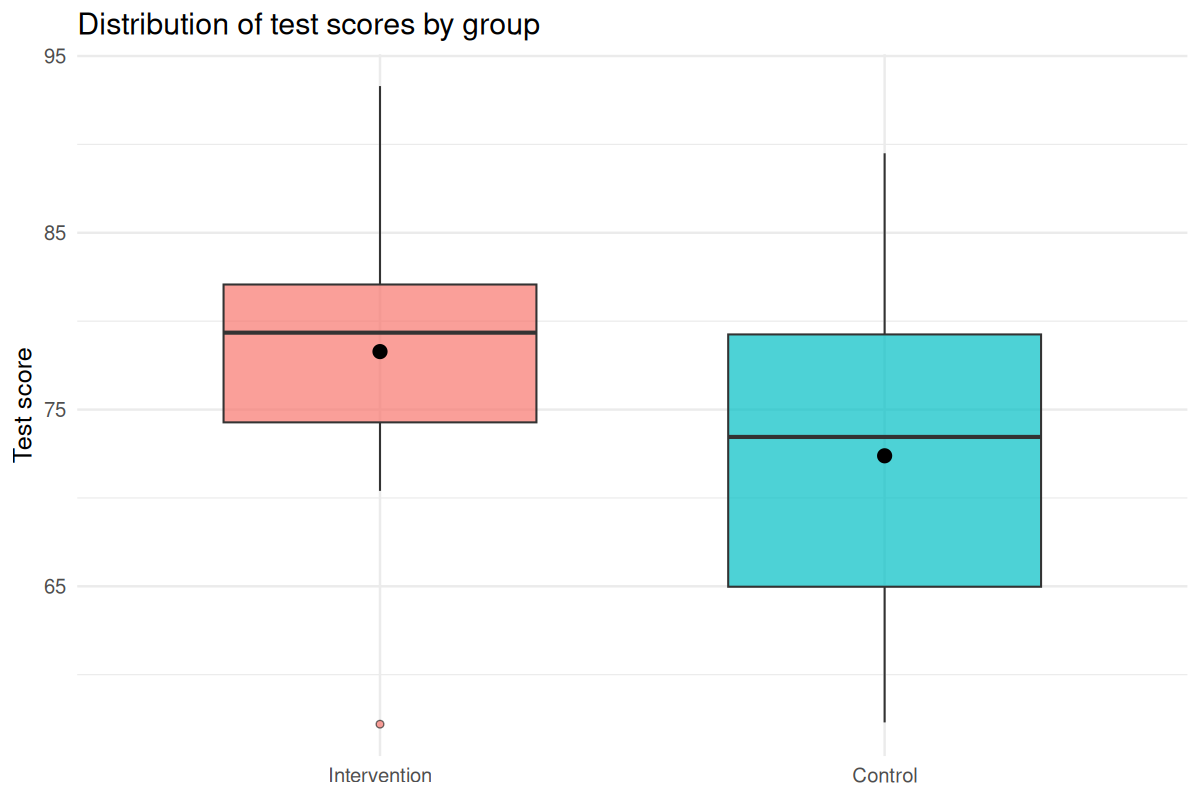
図1 介入群と対照群におけるテストスコアの分布(箱ひげ図)
Figure 1. Distribution of test scores in the intervention and control groups (boxplots).
中央値の位置
介入群の中央値は対照群より高く、分布全体が高得点側へシフトしていることが分かります。
ばらつきの確認
対照群の箱はやや広く、介入群より散らばりが大きいことが示唆されます。等分散の見当をつけるときの参考になります。
平均値の補助表示
黒い点は平均値の位置を示すイメージです。平均差と中央値の差が同じ方向なら、分布解釈がしやすくなります。
外れ値候補の確認
ひげから離れた点があれば、極端な得点が平均差に与える影響を意識します。必要なら元データも確認します。
レポートや論文での書き方
結果記述例(日本語)
介入群のテストスコアは、対照群と比較して有意に高かった(介入群: 78.28 ± 7.22点、対照群: 72.38 ± 9.16点、対応のない t 検定、t(46) = 2.48, p = 0.017, d = 0.72)。図1に両群の得点分布を箱ひげ図で示した。介入群では中央値が高く、分布全体として高得点側へのシフトがみられた。
Report writing example
The intervention group showed significantly higher test scores than the control group (intervention: 78.28 ± 7.22, control: 72.38 ± 9.16; independent samples t-test, t(46) = 2.48, p = 0.017, d = 0.72). Figure 1 presents boxplots of the score distributions, indicating a higher median and an overall upward shift in the intervention group.
図表キャプション例
図1 介入群と対照群におけるテストスコアの分布(箱ひげ図)
Figure 1. Distribution of test scores in the intervention and control groups (boxplots).
自分のデータで実践する
独立した2群になっているかを確認する
同じ人を前後で測ったデータは、この検定の2群に分けるだけでは対応関係を扱えません。群ごとに別の対象者がいること、目的変数の単位が同じこと、群名が意図した2水準になっていることを確認します。欠測を除いた後の人数も群別に記録します。
Welch法とStudent法を区別する
Rのt.test()は、独立2群では既定でWelch法を使います。等分散を仮定するStudent法はvar.equalの指定が異なります。掲載例の方法を自分の研究へ移すときは、出力の検定名と採用した方法が一致しているか確かめます。都合のよいp値を得るために方法を選び直さないでください。
練習課題
2群の平均を引く順序と、出力される平均差の信頼区間の向きを確認してください。群の順序を逆にした場合、差の符号と「どちらが高い」という説明がどう対応するかを書きます。
まず自分で解いてから確認してください。説明や軸名は一例です。数値は掲載データとコードの条件に対応します。
ヒントを見る
記事は介入群−対照群の順です。平均差だけでなく、信頼区間の両端とt値の符号も確認してください。
解答・解説を見る
解答例
介入群−対照群では平均差は5.90点、95%信頼区間は1.11〜10.69点です。逆に対照群−介入群とすると平均差は−5.90点、区間は−10.69〜−1.11点になります。区間は符号を変えた後、下限と上限の順も入れ替わります。
両側のStudentのt検定では、順序を逆にするとt値の符号は反転しますが、p値は同じです。どちらの表現でも「介入群の平均の方が高い」という結論は変わりません。
確認できる値・原文
表は確認コードの実行結果です。表示上の丸めにより、本文の桁数と異なる場合があります。
| 比較 | 平均差 | 95%CI下限 | 95%CI上限 | t | p値 |
|---|---|---|---|---|---|
| Intervention-Control | 5.896 | 1.106 | 10.686 | 2.478 | 0.017 |
| Control-Intervention | -5.896 | -10.686 | -1.106 | -2.478 | 0.017 |
間違えやすい点
両側検定についての説明です。片側検定では、群の順序だけでなく対立仮説の向きも揃える必要があります。
自分の解答を確認する
- 差・区間・t値の向きを揃えている
- 引く順序が変わっても群の大小関係が同じだと説明している
Rで確かめる
この確認コードは、新しいRセッションでも単独で実行できます。作業フォルダはsample-dataの親フォルダにしてください。
d <- read.csv("sample-data/sample_independent_t_scores.csv")
a <- d$score[d$group=="Intervention"]
b <- d$score[d$group=="Control"]
forward <- t.test(a,b,var.equal=TRUE)
reverse <- t.test(b,a,var.equal=TRUE)
answer <- list(direction=data.frame(comparison=c("Intervention-Control","Control-Intervention"),
 difference=c(mean(a)-mean(b),mean(b)-mean(a)),
 lower=c(forward$conf.int[1],reverse$conf.int[1]),upper=c(forward$conf.int[2],reverse$conf.int[2]),
 t=c(unname(forward$statistic),unname(reverse$statistic)),p=c(forward$p.value,reverse$p.value)))

print(answer)
レポートに残す情報
各群の人数・平均・SD、差を取った向き、検定方法、平均差と信頼区間を残します。有意でない結果から、2群が等しいと断定しないようにします。
仕様を確認する資料:R: t.test()
よくあるミス
対応ありデータに使ってしまう
同じ人を前後で測っているのに対応のない t 検定を使うと、対応関係の情報を捨ててしまいます。前後比較なら paired = TRUE を使う対応あり t 検定です。
p 値だけで結論を書く
有意かどうかだけでは、差の大きさや実質的な意味は伝わりません。平均差、95%信頼区間、効果量、図もセットで確認すると説得力が増します。
箱ひげ図を見ずに進める
外れ値候補や分布の偏りを見落とすと、後で結果を適切に解釈するのが難しくなります。検定の前に箱ひげ図かヒストグラムを一度見るだけでも違います。
初心者がひっかかりやすい質問
Q. Student と Welch のどちらを使えばよいですか?
A. 群ごとの分散が近いと考えられるなら Student でも構いませんが、初学者の実務では Welch を使っておく方が安全なことも多いです。ページ内では違いを理解するために両方を示しています。
Q. 箱ひげ図では有意差が分からないのですか?
A. 図だけで傾向は見えますが、有意差の判断は検定結果と一緒に行います。図は「どんな差か」を伝える役割、検定は「その差が偶然かどうか」を考える役割です。
Q. 正規性が少し怪しいときは t 検定を使えませんか?
A. サンプルサイズや歪みの程度によります。軽いずれなら t 検定が大きく崩れないこともありますが、強い外れ値や極端な歪みがある場合は、図を確認しながら代替手法も考えます。
Q. 平均ではなく中央値を比べたいときは?
A. 平均差より順位ベースの比較が合っているなら、Mann-Whitney の U 検定を候補にできます。ただし、何を比べているのかが変わるので、結果の書き方も変わります。
代替手法・次のステップ
研究課題やデータ構造が少し変わると、選ぶべき手法も変わります。別の方法を選ぶ条件を確認しておくと、分析計画が立てやすくなります。
Welch の t 検定
分散が等しいと言いにくいときは、t.test(..., var.equal = FALSE) を使います。R では Welch がデフォルトです。
Mann-Whitney の U 検定
順位に基づく2群比較です。強い歪みや外れ値があるときに候補になりますが、比較している量の意味が t 検定とは異なります。
一元配置 ANOVA
3群以上の独立群をまとめて比べたいときは ANOVA を使います。2群比較の考え方を土台にしながら、群間・群内の変動へ視野を広げます。
参考資料
このページの内容を深掘りしたいときに役立つ、公式ドキュメントと一次資料をまとめています。まずは関数の仕様、その次に補助的な可視化や読み方の資料を見ると理解しやすくなります。
このページの位置づけ
本サイトのトピックページは、Rによるデータ分析の学習支援とレポート作成の補助を目的としたオリジナル解説です。教材には練習用データ、パッケージ同梱データ、公開資料を使用しています。出典・加工内容は各記事のデータ構造と参考資料を確認してください。実データを扱う際には研究計画・前提条件・欠測・外れ値・尺度水準をあらためて確認してください。
編集方針
ページ本文は、標準的な統計手法、Rの公式ドキュメント、一次資料に近い参考文献を優先して整理しています。更新や訂正の方針は編集方針ページで公開しています。