図表から探す
完成した図から作り方を探せます。同じ図表でも、知りたいことに合った分析を選びます。
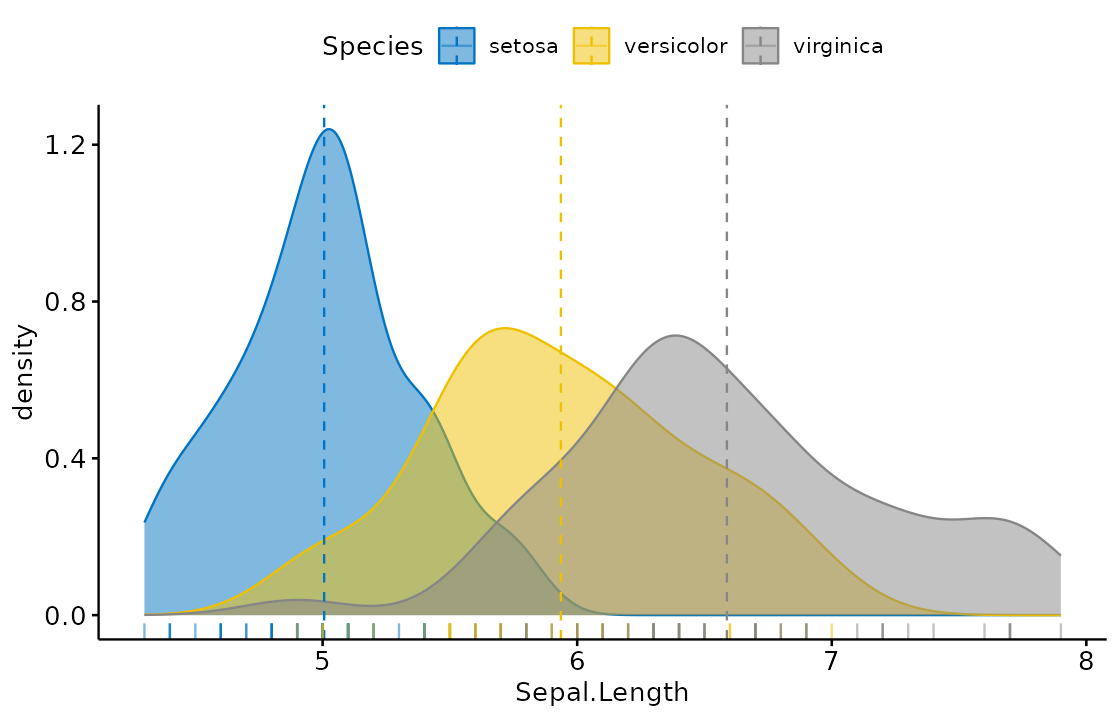
45種類の図表タイプから探す
Likertプロット
MCAバイプロット
PCAバイプロット
QQプロット
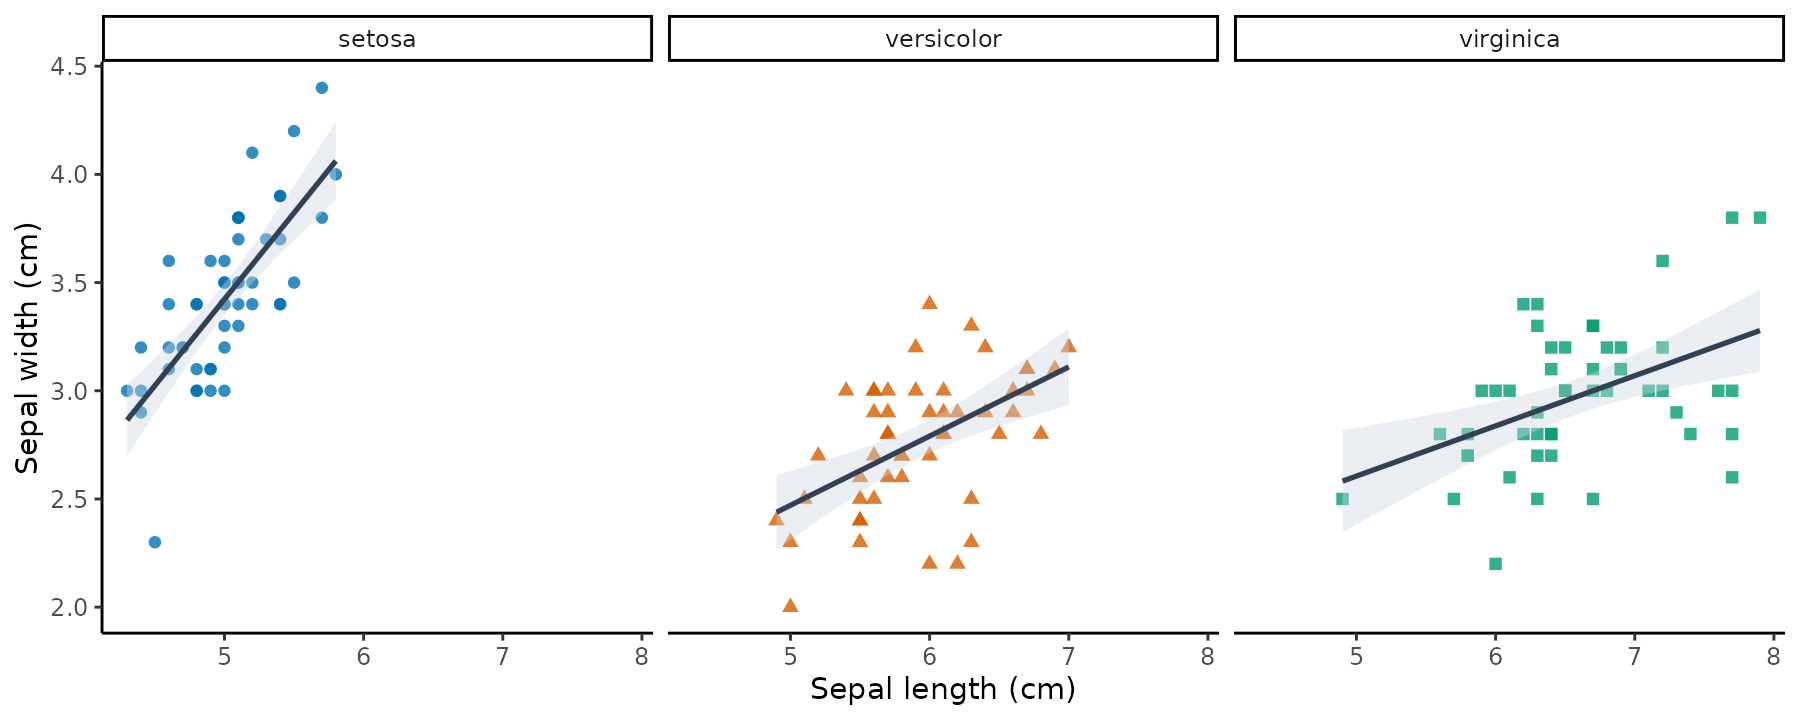
facet図
カテゴリ座標表
クラスタープロット
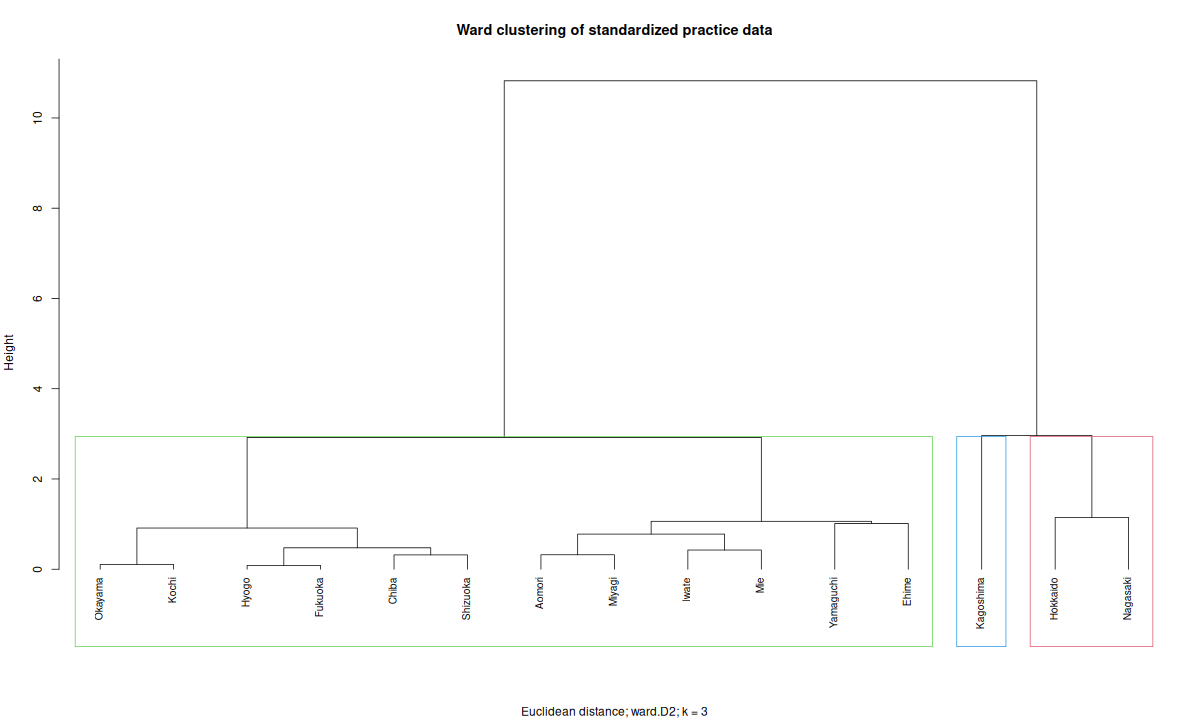
クラスター樹形図
クラスタ記述表
クロス集計表
コロプレス地図
スウォームプロット
スクリプトテンプレート
デンドログラム
ネットワーク図
ノード中心性表
ヒートマップ
ポイントマップ
モザイクプロット
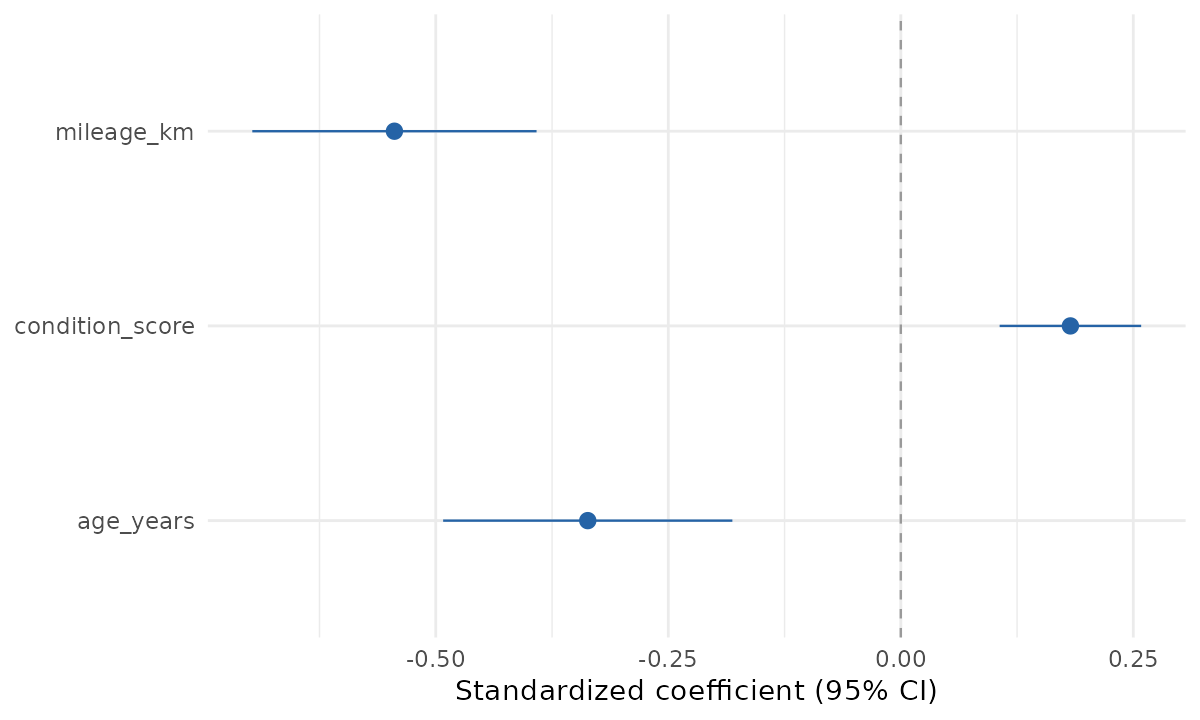
係数プロット
共起ネットワーク
共起ペア表
単語頻度棒グラフ
単語頻度表
固有値表
密度図
感情推移図
感情極性棒グラフ
折れ線グラフ
文字列処理表
比率表
相関係数表
積み上げ棒グラフ
色分け
記述統計表
距離行列ヒートマップ
集計表
記述統計・前処理4記事
地図・空間1記事
R実務・整備3記事
結果を言葉にする
数値を並べるだけでなく、対象、方法、結果、解釈の限界を伝えます。日本語と英語の文例を用意しています。
日本語の記述例
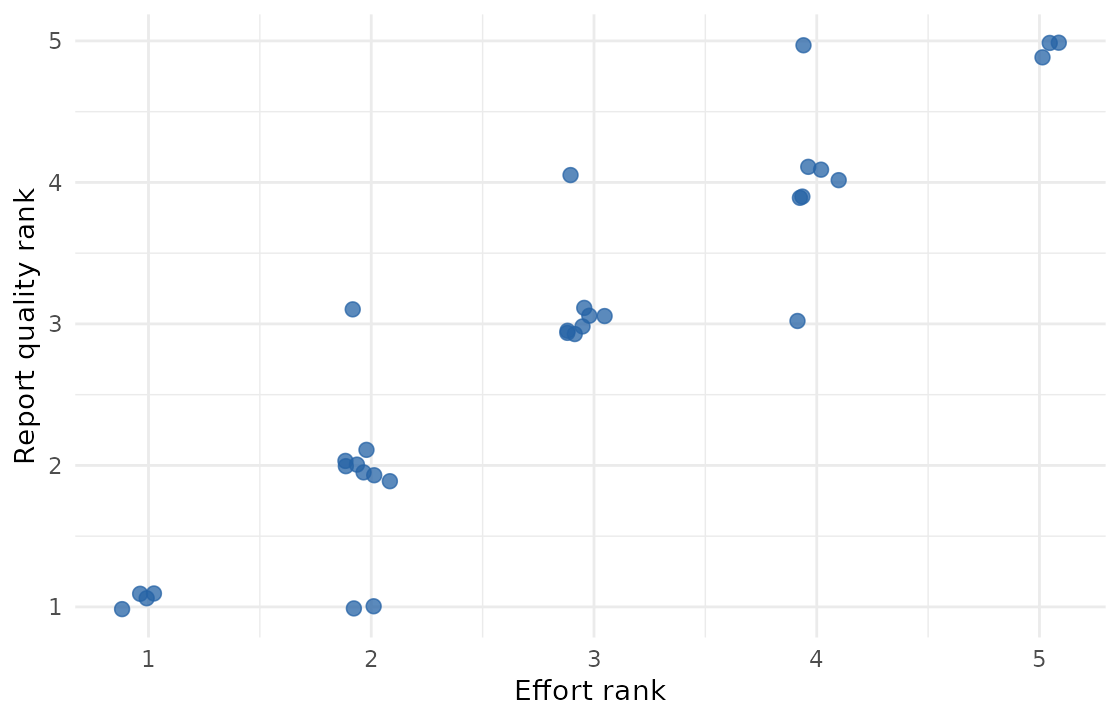
練習データの32組について、スピアマンの順位相関を算出した。努力順位とレポート評価順位の間に正の単調な関連がみられた(ρ = 0.944, p < .001)。この関連から努力の因果効果は判断できない。
英語の記述例
A Spearman rank correlation was calculated for 32 complete pairs in the practice dataset. Effort rank was positively associated with report-quality rank (ρ = 0.944, p < .001). This association does not establish a causal effect of effort.
手法別の文例を探す
グループ比較の書き方
記述統計の書き方
アンケート結果の書き方
地図・空間データの書き方
R実務・整備
図表の整え方
全てのトピック
30記事を、分析名・図表名・キーワードから探せます。
30記事
対応のないt検定
2つの独立したグループの平均差を比較し、箱ひげ図で分布を可視化する基本テーマです。『別々の人からなる2群を比べる』という場面を想定し、Student の t 検定と Welch の t 検定の考え方も含めて、初学者に分かる形で整理します。
対応のあるt検定
同じ対象を介入前後で測定したときに、平均的な変化があるかを評価する方法を学びます。差分の考え方、前提条件、可視化、レポートの書き方までを順に学べます。
一元配置分散分析
3群以上の独立したグループの平均を比較し、F 値・事後比較・効果量の読み方を学びます。『平均との差を見る』だけでなく、『群間の差が群内のばらつきより十分大きいか』という ANOVA の考え方を、初心者にも分かる形で整理します。
カイ二乗検定
2つのカテゴリ変数が「独立か」「関連していそうか」を、クロス集計表・期待度数・標準化残差・モザイクプロットまで含めて読む基本ページです。カテゴリ同士の分析で最もよく出てくる手法を、初心者にも分かるように順番に整理します。
ピアソンの相関
2つの連続変数が一緒に増減するかを、相関係数 r と散布図で確認する基本テーマです。『強さ』と『方向』を短く要約しながら、図を見て外れ値や曲がりを確認する流れを学びます。
単回帰分析
1つの説明変数から1つの連続アウトカムを予測するときの基本テーマです。散布図で関係の形を確認し、lm() の出力から傾き・切片・R²・p値を読む流れを学びます。
重回帰分析
複数の説明変数を同時に入れて、各変数の『他の変数で調整したうえでの関連』を読みたいときの基本テーマです。単回帰より一歩進んで、交絡を意識した説明へ進みます。
ロジスティック回帰
目的変数が合格/不合格、成功/失敗のような 0/1 のときに使う基本テーマです。glm(family = binomial) の出力を読み、係数をオッズ比へ直して解釈する流れを身につけます。
記述統計
分析に入る前の出発点となるページです。数値変数の中心とばらつきを表で整理し、どの指標をどんな場面で使い分けるかを学びます。
グループ別の記述統計
比較分析の前に、各群の基本傾向をそろった形で確認するページです。群ごとの平均、SD、中央値、n を表にまとめ、棒グラフや生データ点で違いの見え方を整理します。
外れ値の確認
極端な値をどう見つけ、どう扱うかを学ぶページです。箱ひげ図で候補を見つけ、IQR ルールで整理し、除外・保持・感度分析の考え方までつなげます。
正規性の確認
分布が概ね正規とみなせるかを確認するページです。図を優先しつつ、Shapiro-Wilk 検定を補助的に使う考え方を整理します。
グループ間の比率比較
グループごとに回答割合がどう違うかを見せたいときの基本テーマです。検定の前段階として『どの群でどの回答が多いか』を可視化し、必要に応じてカイ二乗検定へつなげます。
主成分分析
複数の連続変数を、少数の主成分に要約して全体構造をつかみたいときの基本テーマです。相関のある変数群をまとめて眺める入口として使えます。
k-means法
似た特徴を持つ観測どうしを、事前に決めた k 個のクラスタへ分けたいときの基本テーマです。『群分けを発見する』という感覚をつかむ入口として使えます。
相関行列の可視化
複数変数の関連を一覧で見たいときの基本テーマです。どのペアが高相関か、正負の向きはどうか、多重共線性の懸念があるかを一目で把握できます。
Likert尺度の集計
5段階評価のような順序カテゴリ回答を、項目ごとに比較して見せたいときの基本テーマです。中立カテゴリを中心に置いた Likert プロットで、否定・中立・肯定のバランスを読みやすく整理できます。
ネットワーク分析
R でネットワーク分析をひととおり体験したい人向けの入門ページです。追加データを用意しなくても、公開データセットの Zachary の空手クラブネットワークを使って、読み込み → 中心性の計算 → 可視化 → 書き方まで順に試せます。
テキスト分析の入門
R でテキスト分析をひととおり体験したい人向けの入門ページです。追加データを用意しなくても、Jane Austen の公開テキストを使って、取得 → トークン化 → ストップワード除去 → 単語頻度集計 → 棒グラフ作成まで順に試せます。
共起ネットワーク
単語頻度の棒グラフから一歩進んで、どの語どうしが一緒に現れやすいかを『つながり』として見たいときの発展テーマです。テキスト分析からネットワーク分析へ進む、入門〜初級上の学習に使えます。
多重対応分析
複数のカテゴリ変数を一度に眺めて、どのカテゴリどうしが近いか、回答パターンがどのように分かれるかを見たいときの発展テーマです。PCA に近い考え方でカテゴリ変数を扱う手法として捉えると、理解しやすくなります。
感情分析
単語頻度の棒グラフの次に試しやすいのが、語を positive / negative などの感情語彙へ対応づけて、章や区間ごとの感情の流れを見る感情分析です。このページでは、Jane Austen の Pride & Prejudice を使って、lexicon ベースの最初の感情分析を再現します。
MCAとクラスター分析
MCA でカテゴリ変数の全体配置を見たあとに、「では回答者はどんなまとまりに分かれるのか」をもう一歩踏み込んで見たいときの発展ページです。ここでは FactoMineR の HCPC を使い、MCA の座標を手がかりにクラスタリングする流れを整理します。
Rによる地図描画
R で地図を描く基本的な方法として、まずは sf・rnaturalearth・ggplot2 の組み合わせを覚えるのがおすすめです。このページでは、公開地図データを読み込み、表データを結合し、最初のコロプレス地図とポイントマップを描くところまでの手順を順に説明します。
階層的クラスター分析
似ている観測どうしを、どの順番でひとまとまりにしていくかを見たいときの基本テーマです。hierarchical clustering は、最終的にデンドログラム(樹形図)として結果が返るので、クラスタ数を探索的に考え始めるときに使いやすい手法です。
スピアマンの順位相関
連続変数どうしの直線関係ではなく、順位や 1〜5 の順序尺度、あるいは「だいたい増える・減る」という単調な関係を見たいときの基本テーマです。
重回帰の診断と比較
基本の lm() が動くようになったあとに、「どの説明変数の関連が相対的に強いか」「多重共線性は大丈夫か」「モデル選択はどう考えるか」を整理したい人向けの発展ページです。
文字列の検出・置換・抽出
CSV や Excel を読み込んだあと、商品名・自由記述・ID・単位付き数値の列を少し整えるだけで分析しやすくなることがよくあります。こうした文字列の処理に使えるのが stringr です。
図を整えて保存する
「図は描けるようになったけれど、もう少し見栄え良く整えたい」という段階で役立つ、ggplot2 と ggpubr の実務ページです。
Rスクリプトを整える
統計手法だけでなく、スクリプト自体を「読まれる文書」として整えることも、学生にとって大切な技能です。作業中の自分、未来の自分、共同作業者のために、最低限の整備ポイントをまとめます。